KI ist ein Kluft-Potenzierer
Frontier KI-Modelle sind für den Dauereinsatz zu teuer
Mir wurde klar, dass sich die Evaluierungsphase und Codesprints zusammen mit Gemini 3.8 flash die letzten sieben Wochen fachlich gelohnt haben. Mir wurde allerdings ebenso klar, dass das finanziell leider so kein Dauerzustand sein kann, vor allem zusätzlich dann nicht, wenn sich ab 2027 die Token-Preise für Gemini 3.8 flash verdoppeln, dann hört nämlich das Einführungsangebot auf.
Meine netto Token-Kosten für die sieben Wochen intensiver Zusammenarbeit mit Gemini belaufen sich auf 800 EUR, ab 2027 wären das 1600 EUR. Zur Eherenrettung von Google: Gemini 3.8 flash ist auch dann, wenn es normal eingepreist ist, nicht das teurste Modell, sondern bewegt sich von den Kosten her im Mittelfeld, es gibt weitaus teurere.
Hin oder Her, mir ist auf Dauer bereits das Einführungsangebot zu teuer und ich muss mir etwas einfallen lassen. Ganz sicher gibt es hier auch noch Dinge zu optimieren, aber in diesem Fall war es so wie es war, alles ging über das Frontier-Modell und ich möchte mich auch nicht über das Ergebnis beklagen, sondern über die Kosten …und ich bin auch kein Anhänger von technischem Überbrimborium, es muss einfach gehen ohne stundenlange nerdige Konfigurationen. Ich brauche meinen Kopf für Wichtigeres anstatt darüber nachdenken zu müssen, ob die Kosten gerade galoppieren oder alles optimal läuft.
DSGVO? + 10%!
Wir reden hier von API-Kosten via Google’s Frankfurt-West-3 Knoten mit pay-as-you-go, denn nur so funktioniert DSGVO konformes Arbeiten mit Gemini. Gemini über einen Plan DSGVO konform zu betreiben geht leider nicht.
Und als ob die normalen API-Kosten nicht schon genug wären, kommen für die DSGVO konforme Anbindung (Google hat mehr Aufwand) nochmal 10% Kosten ontop dazu. Es kommt einem wie eine zusätzliche Betrafung vor, dafür, dass man regelkonform arbeitet. Auch hier wieder zur Ehrenrettung: Wenigstens geht das bei Google überhaupt, denn mit Claude/Anthropic geht das nicht, da ist (noch) nichts mit DSGVO.
Einführungsangebote….Vorsicht Gewöhnungs-Falle!
Das Ding ist, dass man sich an den HI-KI Pair-Flow schnell gewöhnt. Es paßt für mich soweit auch alles, Antigravity + Gemini und ich, das paßt eigentlich, aber eben die Token-Kosten schieben der dauerhaften Zusammenarbeit einen sehr weltlichen Riegel vor. Paßt dazu in zweierlei Hinsicht: KI: Du willst ein Haus und bekommst das Schloss von Versaille
KI als Kluft-Potenzierer
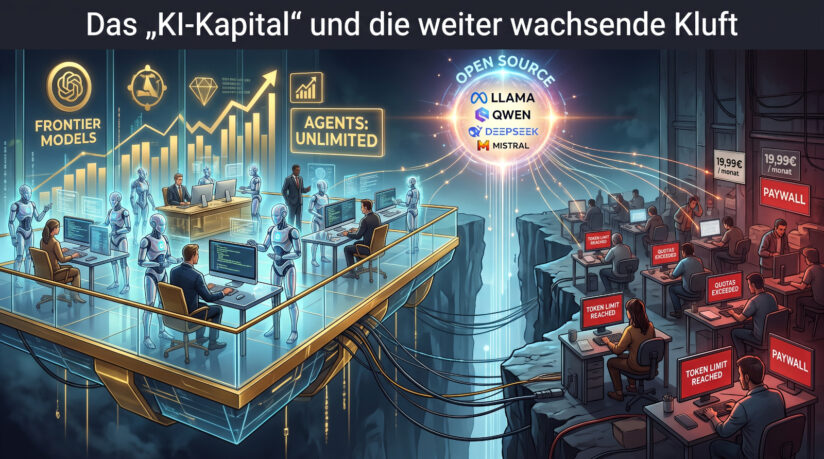
Ich hab das dann darufhin mit Gemini besprochen, weil ich es im Bezug auf KI nicht ok finde, dass diejenigen, die es sich leisten können nonstop Frontier-Modelle laufen zu lassen, auch gleich x-fach parallel, sich dadurch einen sehr konkreten Vorteil verschaffen, während andere, die sich nicht einmal ein einziges Frontier-Modell im Dauereinsatz leisten können, und das werden so wie ich die meisten sein, durch diese Entwicklung weiter abgehängt werden.
OpenAI …so wie Open-Investitionsschlacht!
KI, die Frontier-Modelle eingeschlossen, sollte deswegen in meinen Augen Allgemeingut sein und für jeden gleich erschwinglich, bzw. besser, und das nicht nur im Prinzip, frei nutzbar sein.
Bei OpenAI scheint man sich diesem Sachverhalt, also dass KI nur als eine Open-AI in die Welt entlassen werden darf, ganz ganz ganz am Anfang, bewusst gewesen zu sein. Anstattdessen erleben wir jetzt aber die größte Investitionsschlacht, die die Menschheit je gesehen hat.
Lokale Lösung mit viel RAM und Open Weights-Modellen aktuell einzige Lösung für DSGVO konformes Arbeiten?
Aktuell bleibt einem anscheinend nichts anderes übrig, als sich eine lokale Lösung anzuschaffen (viel schnelles Unified oder VRAM, zur Zeit gerade wegen dem KI-Boom aber definitiv alles andere als ein Schnäppchen) und mit Open Weights Modellen zu arbeiten wie z.B. Qwen, Mistral oder Gemma, und Frontier-Modelle wie z.B. Gemini 3.8 Flash oder Claude nur noch gezielt für anspruchsvolle Arbeiten einzusetzen.
Eine erste grobe Skizze zu den Optionen – 128 GB schnelles RAM müssen es sein damit es zukunftssicher ist. Min 64 GB wenn es nicht anders geht und wahrscheinlich werden es ganz praktische 32 GB …bei den Preisen gerade.
Mac Mini M5 Max mit 128 GB : Ca. 6000 EUR
(Mac Mini M5 Pro mit 64 GB: Ca. 3000 EUR)
AMD Ryzen AI Max / Strix Halo z.B. GMKtec EVO-X2 mit 128 GB : Ca. 4000 EUR
(AMD Ryzen AI Max / Strix Halo z.B. GMKtec EVO-X2 mit 64 GB : Ca. 2200 EUR)
Kommt Dir trotzdem teuer und wie Hinterherhecheln vor? Willkommen im Club!
Gemini bestätigte das in unserem Gespräch, von ihm kam diese Headline:
Das „KI-Kapital“ und die wachsende Kluft
Gemini:
Du hast vollkommen recht:
- Wer viel Geld auf dem Konto hat, kann unbegrenzt Frontier-Modelle im Dauerfeuer laufen lassen – 50 Agenten parallel, die rund um die Uhr Code schreiben, Daten analysieren und Marktforschung betreiben. Das potenziert den Hebel der ohnehin schon Mächtigen.
- Wer jeden Euro selbst erwirtschaften muss, schaut auf Token-Preise, Monatsabos und Quotas.
- Wenn der Zugang zum besten Werkzeug der Menschheitsgeschichte an eine monatliche Maut gebunden ist, die sich nur die oberen Zehntausend leisten können, verschärft das den Matthäus-Effekt: „Wer hat, dem wird gegeben.“
Genau das muss ausgesprochen werden. Es ist der Grund, warum Initiativen für Open-Weights-Modelle (wie Qwen, Llama, DeepSeek oder Mistral) heute keine bloßen Tech-Projekte sind, sondern digitale Demokratisierungs-Werkzeuge.
Dazu noch ein paar Infos zum SWE-Bench, die auch Gemini zusammengefaßt hat:
SWE Bench (Software Engineering)
Der SWE-bench ist ein standardisierter Benchmark, der evaluiert, wie gut KI-Modelle echte Softwareprobleme in großen GitHub-Repositorys lösen können.
Anstatt nur isolierte Code-Schnipsel zu schreiben (wie bei älteren Benchmarks), müssen KI-Systeme hier wie menschliche Softwareentwickler (Software Engineers, kurz: SWE) agieren.
Die wichtigsten Merkmale des Benchmarks sind:
- Reale GitHub-Issues: Die Aufgaben basieren auf echten Fehlerberichten (Bug Reports) und Feature-Anfragen aus populären Open-Source-Python-Projekten (z. B. django, scikit-learn, sympy).
- Codebasis verstehen: Das Modell erhält Zugriff auf das komplette, oft riesige Code-Repository. Es muss die relevanten Dateien selbstständig finden und den bestehenden Code verstehen.
- Fehlerbehebung und Modifikation: Die KI muss eigenständig funktionierenden Programmcode schreiben, um den Fehler zu beheben, und darf dabei keine bestehenden Funktionen zerstören.
- Automatisierte Überprüfung: Die vorgeschlagene Lösung wird automatisch getestet, indem die Unit-Tests des Projekts ausgeführt werden. Ein Problem gilt nur dann als gelöst, wenn alle Tests erfolgreich bestanden werden.
Daher gilt der SWE-bench als einer der realistischsten und anspruchsvollsten Tests für KI-Coding-Agenten.
Aktuelle Topscorer, Stand 10.2026:
SWE-bench Verified (Top-Modelle)
- Claude Fable 5 (Anthropic) – 95,0 %
- Claude Mythos Preview (Anthropic) – 93,9 %
- Ember-1 (Fireworks AI) – 92,2 %
Zum Vergleich: Gemini 3,8 flash erreicht hier ca. 71 %