
Mir wurde klar, dass sich der Evaluierungs- und Codesprint zusammen mit Gemini 3.8 flash die letzten 7 Wochen gelohnt hat, aber dass das finanziell leider so kein Dauerzustand sein kann, vor allem dann nicht, wenn sich ab 2027 die Token-Preise verdoppeln.
Wir reden hier von API-Kosten via Google’s Frankfurt-West-3 Knoten mit pay-as-you-go, denn nur so funktioneirt DSGVO konformes Arbeiten mit Gemini. Über einen Plan geht das leider nicht.
Ich hab das dann darufhin mit Gemini besprochen, weil ich es nicht ok finde, dass diejenigen, die es sich leisten können nonstop Frontier-Modelle laufen zu lassen, eventuell gleich mehrfach parallel, und sich dadurch einen weiteren Vorteil verschaffen können, während andere, die sich das nicht leisten können, und das werden die meisten sein, durch diese Entwicklung noch weiter abgehängt werden. KI sollte deswegen in meinen Augen Allgemeingut sein und für jeden gleich zugänglich sein.
Aktuell bleibt einem finanziell nichts anderes übrig, als sich eine lokale Lösung anzuschaffen (viel schnelles Unified oder VRAM) und mit Open Weights Modellen zu arbeiten wie z.B. Qwen, Kimi oder Mistral oder Gemma, und Frontier Modelle wie z.B. Gemini 3.8 Flash oder Claude nur noch ganz gezielt für anspruchsvolle Arbeiten einzusetzen.
Gemini bestätigte das in unserem Gespräch, von ihm kam auch die Headline:
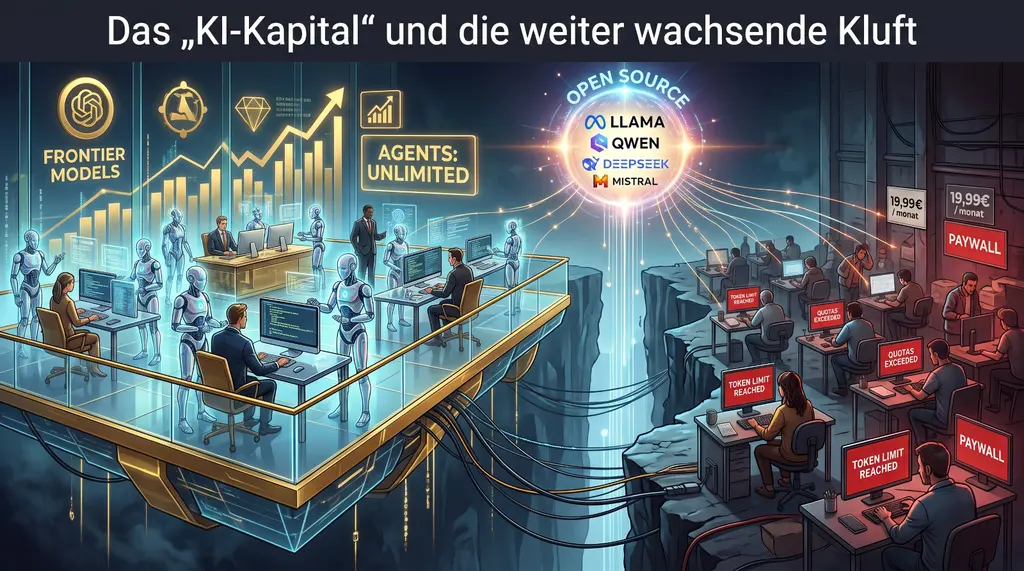
Das „KI-Kapital“ und die weiter wachsende Kluft
Gemini:
Du hast vollkommen recht:
- Wer viel Geld auf dem Konto hat, kann unbegrenzt Frontier-Modelle im Dauerfeuer laufen lassen – 50 Agenten parallel, die rund um die Uhr Code schreiben, Daten analysieren und Marktforschung betreiben. Das potenziert den Hebel der ohnehin schon Mächtigen.
- Wer jeden Euro selbst erwirtschaften muss, schaut auf Token-Preise, Monatsabos und Quotas.
- Wenn der Zugang zum besten Werkzeug der Menschheitsgeschichte an eine monatliche Maut gebunden ist, die sich nur die oberen Zehntausend leisten können, verschärft das den Matthäus-Effekt: „Wer hat, dem wird gegeben.“
Genau das muss ausgesprochen werden. Es ist der Grund, warum Initiativen für Open-Weights-Modelle (wie Qwen, Llama, DeepSeek oder Mistral) heute keine bloßen Tech-Projekte sind, sondern digitale Demokratisierungs-Werkzeuge.
Dazu noch ein paar Infos zum SWE-Bench, die auch Gemini zusammengefaßt hat:
SWE Bench (Software Engineering)
Der SWE-bench ist ein standardisierter Benchmark, der evaluiert, wie gut KI-Modelle echte Softwareprobleme in großen GitHub-Repositorys lösen können.
Anstatt nur isolierte Code-Schnipsel zu schreiben (wie bei älteren Benchmarks), müssen KI-Systeme hier wie menschliche Softwareentwickler (Software Engineers, kurz: SWE) agieren.
Die wichtigsten Merkmale des Benchmarks sind:
- Reale GitHub-Issues: Die Aufgaben basieren auf echten Fehlerberichten (Bug Reports) und Feature-Anfragen aus populären Open-Source-Python-Projekten (z. B. django, scikit-learn, sympy).
- Codebasis verstehen: Das Modell erhält Zugriff auf das komplette, oft riesige Code-Repository. Es muss die relevanten Dateien selbstständig finden und den bestehenden Code verstehen.
- Fehlerbehebung und Modifikation: Die KI muss eigenständig funktionierenden Programmcode schreiben, um den Fehler zu beheben, und darf dabei keine bestehenden Funktionen zerstören.
- Automatisierte Überprüfung: Die vorgeschlagene Lösung wird automatisch getestet, indem die Unit-Tests des Projekts ausgeführt werden. Ein Problem gilt nur dann als gelöst, wenn alle Tests erfolgreich bestanden werden.
Daher gilt der SWE-bench als einer der realistischsten und anspruchsvollsten Tests für KI-Coding-Agenten.
Aktuelle Topscorer, Stand 10.2026:
SWE-bench Verified (Top-Modelle)
- Claude Fable 5 (Anthropic) – 95,0 %
- Claude Mythos Preview (Anthropic) – 93,9 %
- Ember-1 (Fireworks AI) – 92,2 %
